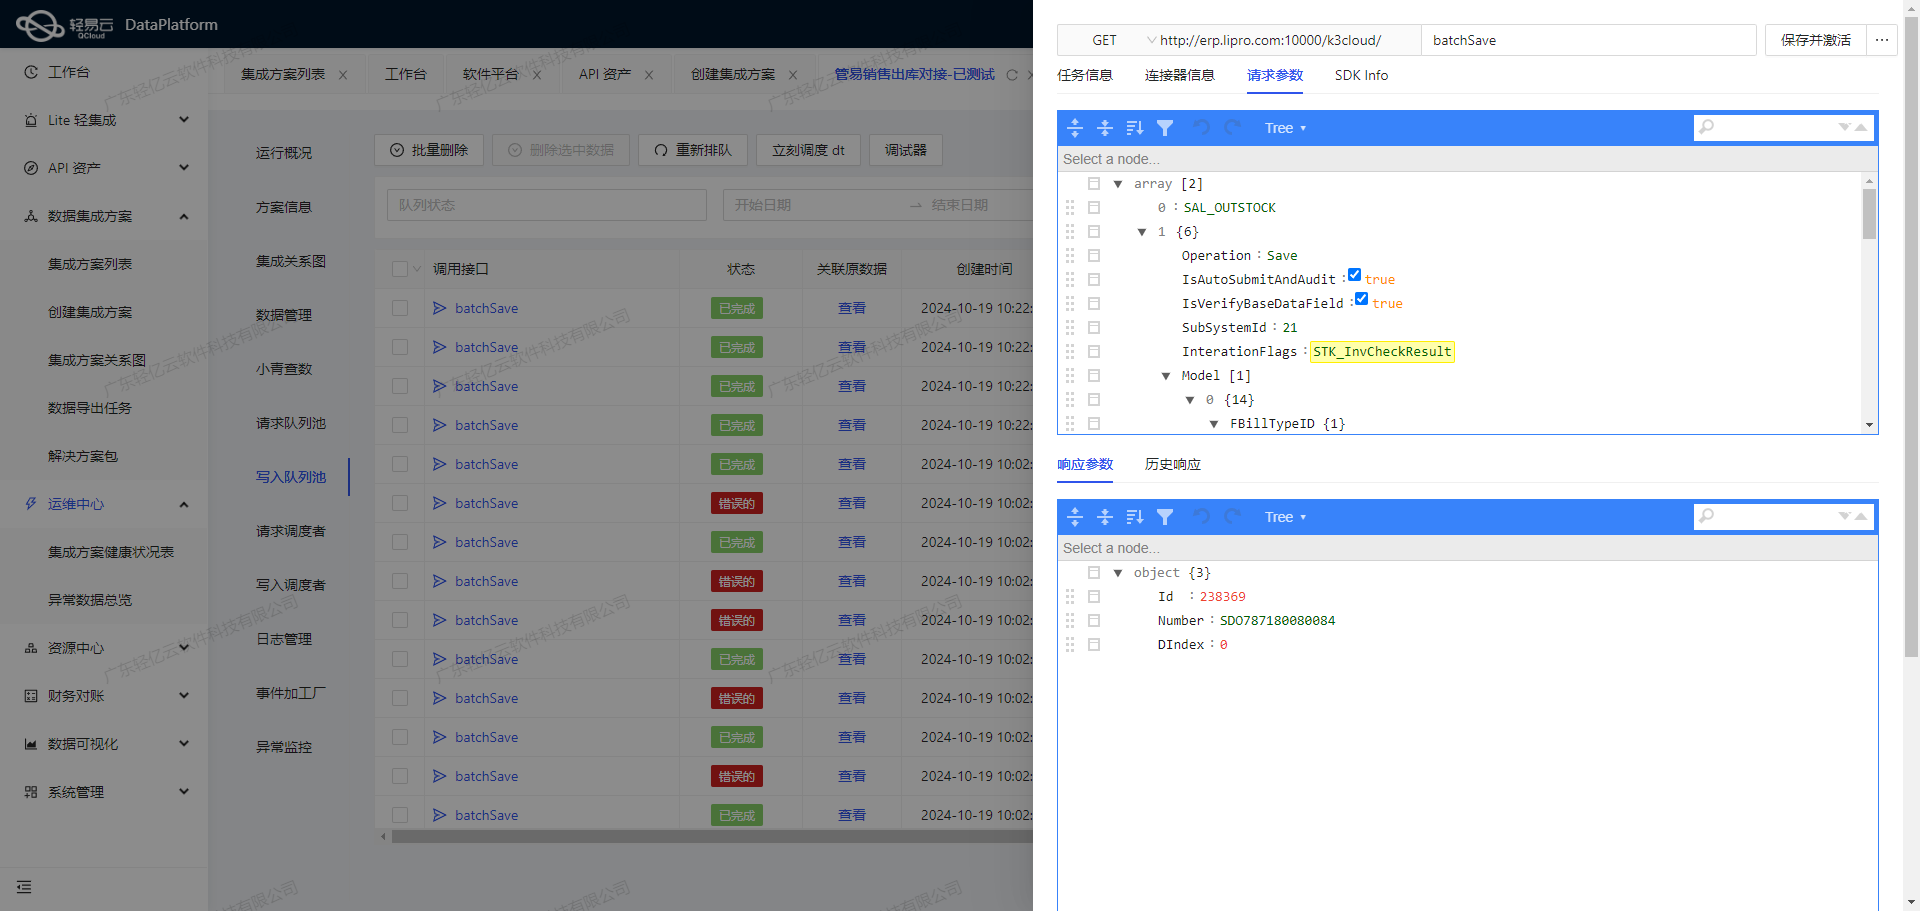
Dans l'écosystème de la gestion d'entreprise moderne, la fluidité et la précision des données financières sont essenteilles. Cet article détaille une étude de cas technique portant sur l'intégration des nouveaux bordereaux de paiement et de remboursement depuis DingTalk vers une base de données MySQL. L'objectif est d'assurer une réplication fidèle et performante des données transactionnelles.
Pour cette intégration, nous exploitons l'API DingTalk v1.0/yida/processes/instances pour l'extraction des données et l'interface execute de MySQL pour l'insertion. Voici les piliers techniques de cette solution :
- Haute performance d'écriture : Optimisation du débit pour absorber de gros volumes de transactions sans latence.
- Surveillance et alertes centralisées : Suivi en temps réel de l'état des tâches d'intégration pour une réactivité immédiate en cas d'anomalie.
- Logique de transformation personnalisée : Adaptation structurelle des données pour combler les écarts de schéma entre DingTalk et MySQL.
- Contrôle du flux et pagination : Gestion rigoureuse des limites de l'API DingTalk pour éviter les blocages de requêtes (rate limiting).
- Résilience et tentatives automatiques : Mécanisme robuste de gestion des erreurs garantissant qu'aucune donnée n'est perdue.
Extraction et traitement via l'API DingTalk
La première phase consiste à interroger l'API DingTalk pour récupérer les instances de processus liées aux paiements. La configuration des paramètres est cruciale pour cibler les données exactes.
Configuration de la requête API
L'appel POST nécessite des identifiants spécifiques et des paramètres de filtrage. Voici une structure type de la configuration de la requête :
{
  "page_index": 1,
  "page_limit": 50,
  "app_code": "APP_WTSCMZ1WOOHGIM5N28BQ",
  "secure_token": "IS866HB1DXJ8ODN3EXSVD750RBTK2X72R8MELL4",
  "operator_id": "16000443318138909",
  "form_id": "FORM-OS566L910XZ9MAUKDXIG9BZKX2P12AUKTGKGL5",
  "search_criteria": {
    "status": "COMPLETED"
  }
}
Nettoyage et normalisation des données
Une fois les données brutes extraites, un traitement est nécessaire pour les rendre compatibles avec le schéma SQL de destination. Par exemple, la conversion des formats de date et le renommage des champs techniques :
- Conversion du champ
dateField_lgkgut9rverspayment_timestamp. - Transformation de
serialNumberField_lgorr6rventransaction_id_clean.
Exemple de règle de transformation :
{
  "transformation_rules": [
    {"source": "dateField_lgkgut9r", "target": "payment_date", "type": "datetime"},
    {"source": "serialNumberField_lgorr6rv", "target": "ref_order", "type": "string"}
  ]
}
Logique de gestion de la pagination
Pour traiter des milliers d'enregistrements, une boucle de paginasion est implémentée pour parcourir l'ensemble des résultats disponibles sur l'API source :
def fetch_dingtalk_data(current_page, limit):
    while True:
        payload = build_payload(current_page, limit)
        response = execute_post_request(DINGTALK_URL, payload)

        if not response.get('data_list'):
            break

        process_batch(response['data_list'])
        current_page += 1
Phase ETL et injection dans MySQL
La seconde étape majeure concerne la transformation finale (ETL) et l'exécution de l'écriture dans MySQL via son API de gestion.
Le mapping des données assure que chaque attribut de DingTalk trouve sa place dans la table MySQL. Voici comment les paramètres principaux sont structurés pour l'insertion :
{
    "action": "insert_records",
    "target_table": "finance_records",
    "data_map": {
        "external_id": "{{instance_id}}",
        "order_reference": "{ref_order}_REF",
        "transaction_time": "{payment_date}",
        "quantity": "1",
        "total_amount": "{amount_field}",
        "record_status": "synced",
        "doc_category": "Remboursement_Paiement"
    }
}
Gestion des erreurs et intégrité
Lors de l'écriture, si une contrainte d'intégrité est violée ou si la base est temporairement indisponible, le système capture l'exception. Un journal d'erreurs est alimenté, et une file d'attente de retraitement est activée pour garantir la cohérence finale du système.
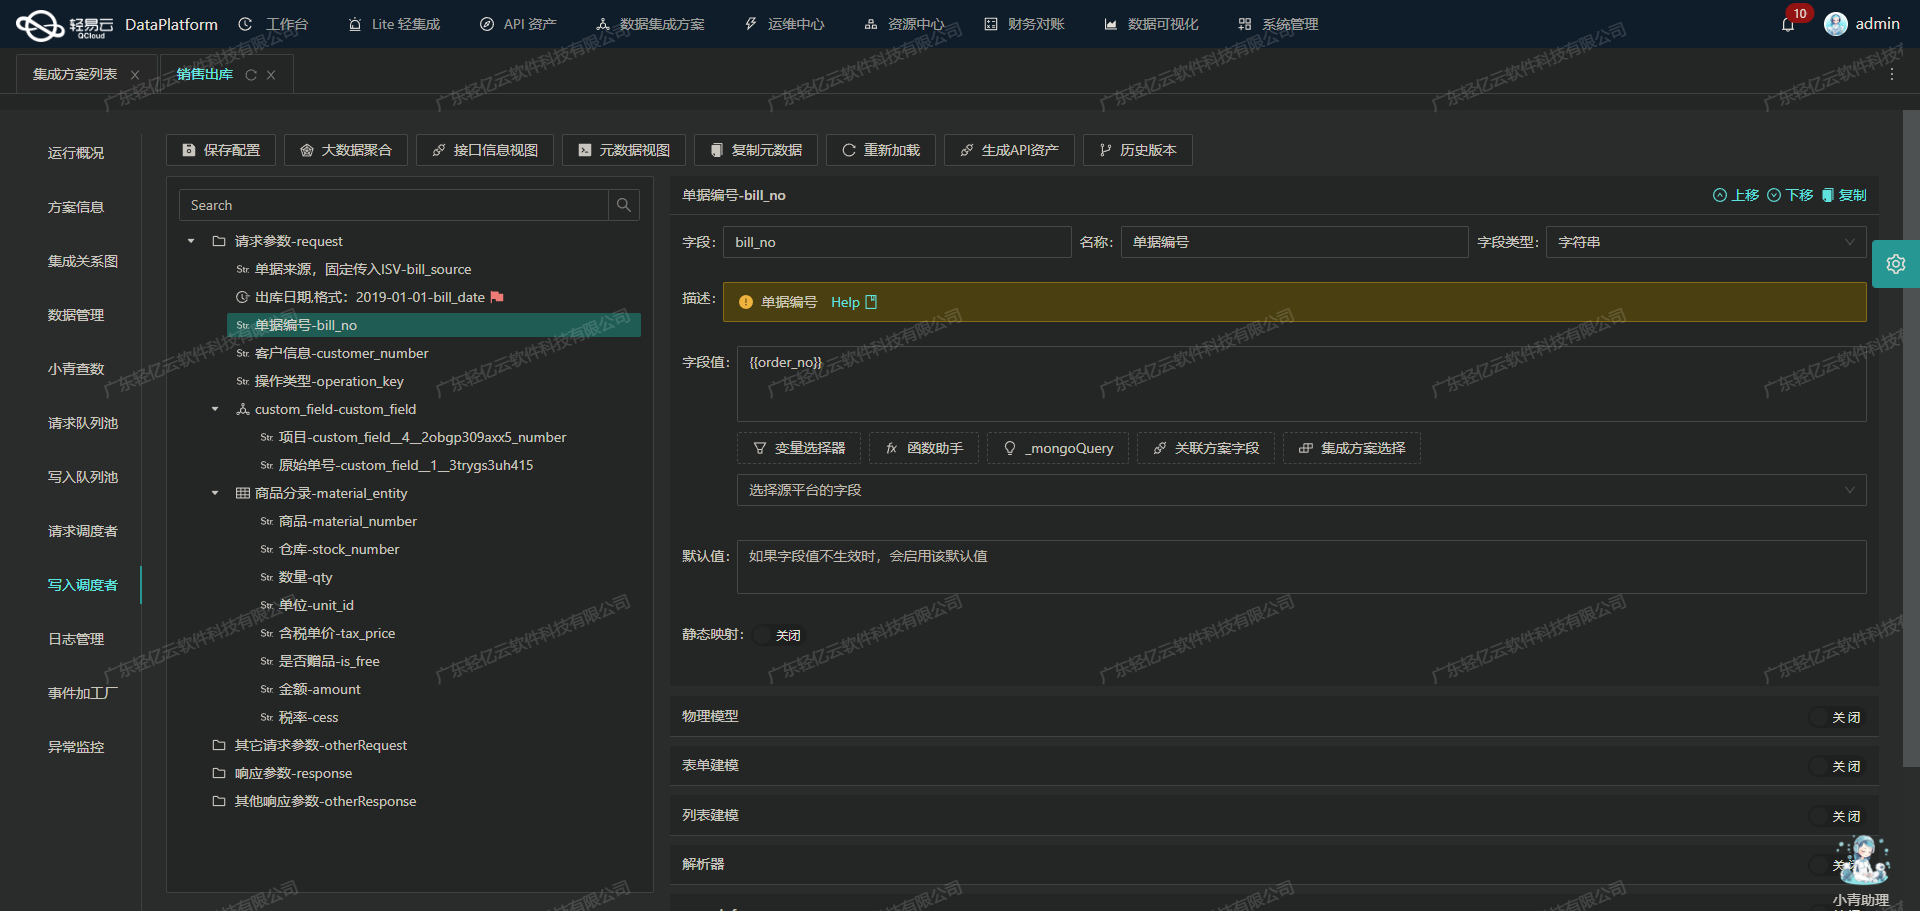
Grâce à cette architecture, l'intégration entre DingTalk et MySQL devient un processus transparent, sécurisé et hautement supervisé, permettant aux équipes financières de disposer de données à jour pour leurs analyses comptables.